Wer ein offenes Sprachmodell wie Gemma 4 31B für mehrere gleichzeitige Nutzer selbst hosten will, landet schnell bei der Hardware-Frage. Vorher stehen zwei andere Fragen:
- Welches Modell brauchst du? Gemma 4 gibt es auch als Mixture-of-Experts-Variante 26B A4B, die je Token 3,8 von 25,2 Mrd. Parametern aktiviert (laut Gemma-4-Modellkarte, Stand: 08.11.2026).
- Brauchst du eigene Hardware? Ob Kauf oder Miete passt, hängt von Auslastung, Strom und Laufzeit ab. RackDiff listet derzeit keine GPU-Server.
Dieser Guide ordnet Modelle nach Dateigröße und RAM-Klasse ein. Er zeigt, was Ollama, llama.cpp-Server und vLLM bei mehreren Nutzern unterscheidet und welche Kostenfaktoren bei Kauf und Miete zählen.
Welcher Server für dein Modell?
Der Ollama-Rechner schätzt aus Modellgröße, Open WebUI und RAG den RAM-Bedarf und zeigt passende Server; wie die Liste gewichtet ist, steht auf der Methodik-Seite.
Zum Ollama VPS-RechnerDie Kurzantwort
| Szenario | Modellbeispiele | RAM-Klasse | Server |
|---|---|---|---|
| Ausprobieren, 1 Nutzer | Llama 3.2 3B, Gemma 4 E2B | 8 GB | VPS-Vergleich |
| 1 Nutzer, Chat und Automatisierung | Qwen3 8B, Gemma 4 12B | 16 GB | VPS-Vergleich |
| Kleines Team, nicht alle gleichzeitig | Gemma 4 26B A4B, Qwen3-30B-A3B | 32 GB | VPS oder Dedicated |
| Viele gleichzeitige Nutzer, 30B-Klasse | Gemma 4 31B | GPU | RackDiff listet derzeit keine GPU-Server |
Die Details der Reihe nach.
Was bestimmt, ob ein Modell auf deinem Server läuft?
Drei Faktoren:
1. RAM: Gewichte + Context + System
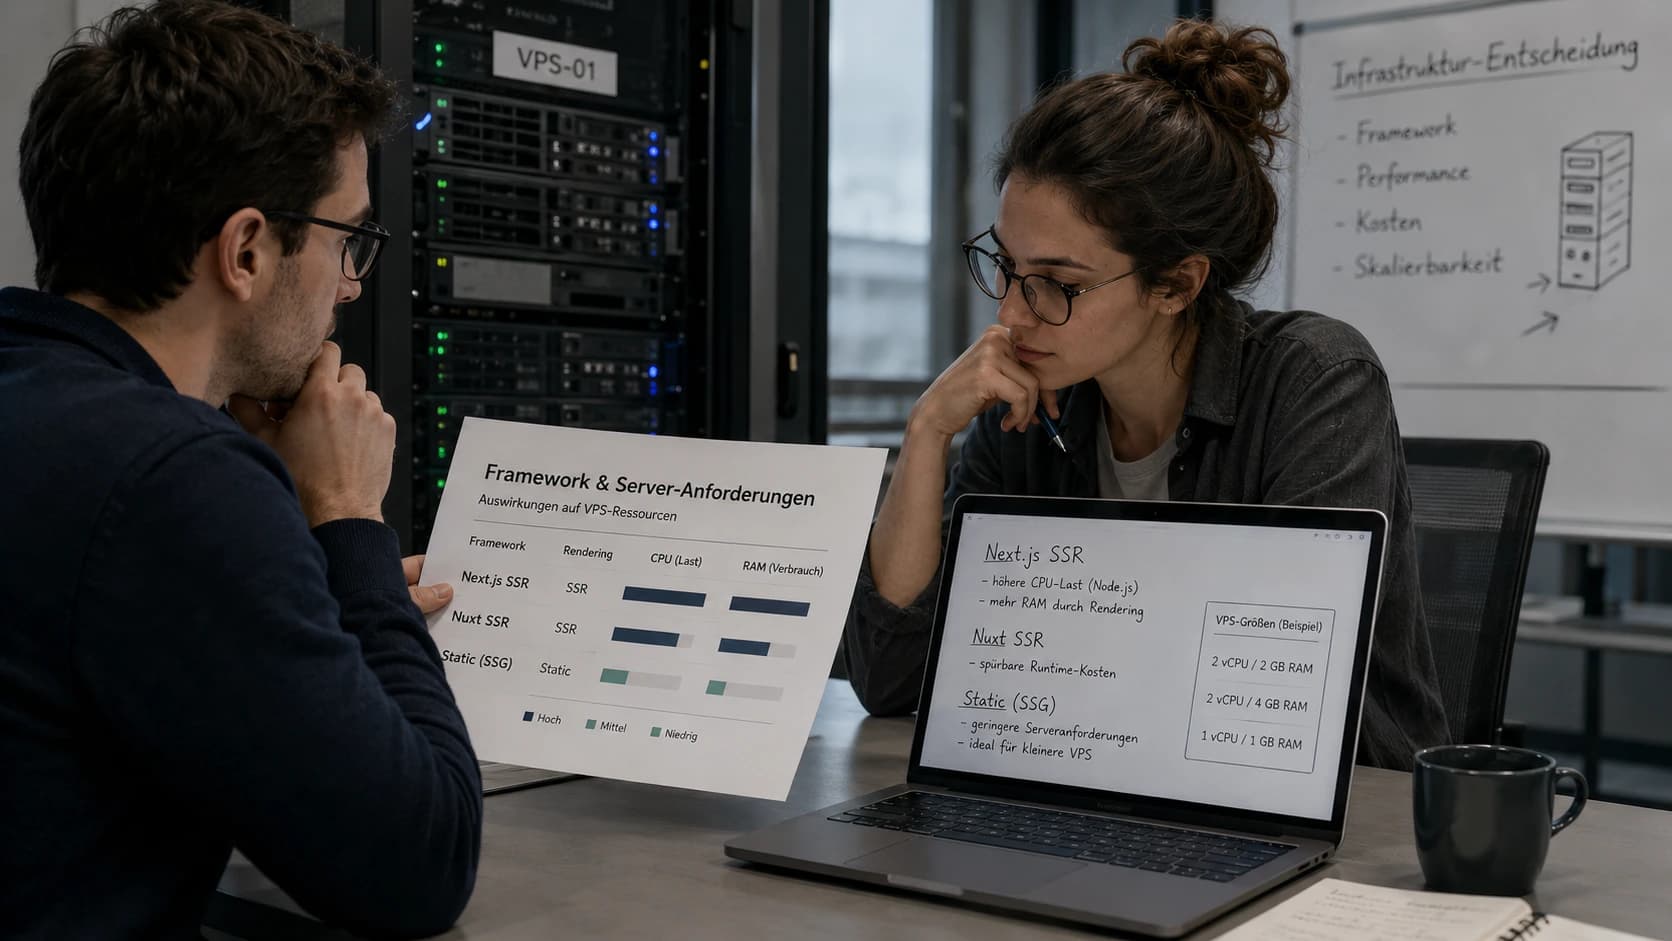
Den Speicherbedarf der Modellgewichte zeigt die Dateigröße im Tag-Verzeichnis von Ollama, etwa 5,2 GB für qwen3:8b (laut ollama.com, Stand: 08.11.2026) und 4,9 GB für llama3.1:8b in q4_K_M (laut ollama.com, Stand: 08.11.2026). Dazu kommen Kontext (KV-Cache) und System; mit 16 GB bleibt mehr Platz für längere Kontexte und weitere Container.
Der RAM-Bedarf skaliert mit OLLAMA_NUM_PARALLEL × OLLAMA_CONTEXT_LENGTH; die Standard-Kontextlänge ist 4096 Tokens (laut Ollama-FAQ, Stand: 08.11.2026).
2. CPU: Kerne und Befehlssätze
Was dedizierte vCPUs von geteilten unterscheidet und welche Tarife sie bieten, zeigt der VPS-Vergleich.
llama.cpp unterstützt auf x86 AVX, AVX2, AVX512 und AMX (laut llama.cpp, Stand: 08.11.2026). vLLM nennt für CPU-Betrieb avx512f als empfohlen und avx2 mit eingeschränktem Funktionsumfang (laut vLLM-Doku, Stand: 08.11.2026). Welche Flags dein Server hat, zeigt lscpu.
3. Quantisierung: Q4_K_M und Q8_0
Q4_K_M-Varianten sind kleiner als Q8_0, etwa 5,2 statt 8,9 GB bei qwen3:8b (laut ollama.com, Stand: 08.11.2026) und 18 statt 28 GB bei Gemma 4 26B A4B (laut ollama.com, Stand: 08.11.2026). llama.cpp unterstützt Quantisierung von 1,5 bis 8 Bit (laut llama.cpp, Stand: 08.11.2026). Mehr zur Quantisierung im Coding-Assistant-Guide.
Mixture-of-Experts: Viele Parameter, wenige davon aktiv
Ergänzend zum Ollama-Setup-Guide: Ein Mixture-of-Experts-Modell (MoE) hat viele Parameter, aktiviert pro Token aber nur einen Teil davon (laut Gemma-4-Modellkarte, Stand: 08.11.2026).
Ein Beispiel ist die Gemma-4-Familie:
| Modell | Architektur | Parameter | Kontext | Dateigröße q4_K_M |
|---|---|---|---|---|
| Gemma 4 E2B | dicht | 2,3 Mrd. effektiv (5,1 Mrd. mit Embeddings) | 128K | 4,6 GB |
| Gemma 4 E4B | dicht | 4,5 Mrd. effektiv (8 Mrd. mit Embeddings) | 128K | 6,6 GB |
| Gemma 4 12B | dicht | 11,95 Mrd. | 256K | 8,0 GB |
| Gemma 4 26B A4B | MoE, 8 von 128 Experten aktiv plus 1 geteilter | 25,2 Mrd., davon 3,8 Mrd. aktiv | 256K | 18 GB |
| Gemma 4 31B | dicht | 30,7 Mrd. | 256K | 20 GB |
Architektur, Parameter und Kontext laut Gemma-4-Modellkarte, Dateigrößen laut ollama.com, Stand: 08.11.2026.
Gemma 4 26B A4B hat 25,2 Mrd. Parameter und aktiviert je Token 3,8 Mrd.; laut Modellkarte läuft es fast so schnell wie ein 4B-Modell (laut Gemma-4-Modellkarte, Stand: 08.11.2026). Im Speicher liegt trotzdem das ganze Modell, in q4_K_M 18 GB (laut ollama.com, Stand: 08.11.2026).
Ebenfalls MoE sind Qwen3-30B-A3B mit 30,5 Mrd. Parametern, davon 3,3 Mrd. aktiviert (laut Qwen3-Modellkarte, Stand: 08.11.2026), und gpt-oss-20b mit 21 Mrd. Parametern, davon 3,6 Mrd. aktiv, laut Modellkarte lauffähig in 16 GB Speicher (laut gpt-oss-Modellkarte, Stand: 08.11.2026). Für einen CPU-Server kannst du MoE-Varianten in die Auswahl nehmen; RAM brauchen sie für alle Parameter.
Das dichte Gemma 4 31B (30,7 Mrd. Parameter) belegt in q4_K_M 20 GB (laut Gemma-4-Modellkarte, Stand: 08.11.2026; laut ollama.com, Stand: 08.11.2026).
Modell-Matrix: Welche Modellgröße passt in welche RAM-Klasse?
| Server | RAM | Modelle (Dateigröße q4_K_M) |
|---|---|---|
| VPS-Vergleich | 8 GB | Llama 3.2 3B (2,0 GB), Gemma 4 E2B (4,6 GB), Gemma 4 E4B (6,6 GB), Mistral 7B (4,4 GB) |
| VPS-Vergleich | 16 GB | Llama 3.1 8B (4,9 GB), Gemma 4 12B (8,0 GB), Qwen3 14B (9,3 GB) |
| VPS-Vergleich | 32 GB | gpt-oss-20b (14 GB, MXFP4; laut Modellkarte in 16 GB lauffähig, mit Kontext und System knapp), Gemma 4 26B A4B (18 GB), Qwen3-30B-A3B (19 GB), Mistral Small 24B (14 GB), Gemma 4 31B (20 GB) |
| Dedicated Server | 64 GB+ | Llama 3.3 70B (43 GB) |
| GPU-Server | – | RackDiff listet derzeit keine GPU-Server. |
Dateigrößen laut ollama.com, Tag-Verzeichnisse llama3.2, llama3.1, llama3.3, gemma4, qwen3, gpt-oss, mistral und mistral-small, Stand: 08.11.2026.
Tarife mit 32 GB RAM zeigen der VPS-Vergleich und der Dedicated-Vergleich mit Preisen inkl. USt und Stand der Preise.
Mehrere gleichzeitige Nutzer: Ollama, llama.cpp-Server und vLLM
Wie viele Anfragen gleichzeitig bearbeitet werden, hängt neben der Hardware von der Serving-Software und ihren Einstellungen ab.
Ollama bearbeitet standardmäßig eine Anfrage je Modell gleichzeitig (OLLAMA_NUM_PARALLEL, Standard 1) und stellt weitere in eine Warteschlange (OLLAMA_MAX_QUEUE, Standard 512) (laut Ollama-FAQ, Stand: 08.11.2026). Mehr parallele Anfragen erhöhen den RAM-Bedarf (OLLAMA_NUM_PARALLEL × OLLAMA_CONTEXT_LENGTH).
vLLM nennt Continuous Batching eingehender Anfragen und PagedAttention als Funktionen (laut vLLM-Doku, Stand: 08.11.2026). Auch der llama.cpp-Server bietet paralleles Decoding für mehrere Nutzer und Continuous Batching, standardmäßig aktiv (laut llama.cpp-Server-README, Stand: 08.11.2026).
Was du einstellen kannst:
- Ollama:
OLLAMA_NUM_PARALLELerhöhen und RAM je paralleler Anfrage einplanen (laut Ollama-FAQ, Stand: 08.11.2026). - llama.cpp-Server: Zahl der Slots über
-np/--parallel, Standard automatisch (laut llama.cpp-Server-README, Stand: 08.11.2026). - vLLM: Auf CPU nennt die Doku die Datentypen FP32, FP16 und BF16 sowie die Quantisierungen AWQ, GPTQ und INT8 W8A8 (laut vLLM-Doku, Stand: 08.11.2026).
Auf einem CPU-Server teilen sich alle aktiven Anfragen dieselben Kerne und denselben Speicher. VRAM-Werte für GPU-Betrieb nennen die Modellkarten von Gemma 4 und Qwen3 nicht; RackDiff listet derzeit keine GPU-Server.
Jede parallele Anfrage braucht eigenen Kontextspeicher. Ollama kann den KV-Cache mit OLLAMA_KV_CACHE_TYPE quantisieren (q8_0 etwa halber Speicher von f16), wenn Flash Attention aktiv ist (OLLAMA_FLASH_ATTENTION=1) (laut Ollama-FAQ, Stand: 08.11.2026).
Kaufen oder mieten? Kostenfaktoren für eigene LLM-Hardware
Beim Selbstbetrieb kommt Strom dazu: Leistungsaufnahme laut Datenblatt der Komponenten mit deinem Stromtarif und der geplanten Laufzeit durchrechnen.
Dazu kommen Ersatz bei Defekten, Wertverlust der Hardware und die Frage, ob künftige Modelle in denselben Speicher passen.
Kauf und Miete unterscheiden sich bei Auslastung, Laufzeit und Betrieb. Mindestlaufzeit und Kündigungsfrist stehen beim jeweiligen Tarif; Preise inkl. USt zeigen der VPS-Vergleich und der Dedicated-Vergleich.
Auch die Modellwahl verschiebt den Speicherbedarf: Das 26B A4B belegt in q4_K_M 18 GB statt 20 GB beim dichten 31B (laut ollama.com, Stand: 08.11.2026) und aktiviert je Token 3,8 statt 30,7 Mrd. Parameter (laut Gemma-4-Modellkarte, Stand: 08.11.2026).
Beispiel-Setups nach Szenario
Ausprobieren, ein Nutzer. Ein VPS mit 8 GB RAM (VPS-Vergleich) mit Ollama und Llama 3.2 3B oder Gemma 4 E2B (Größen in der Modell-Matrix) für persönliche Chats und Textzusammenfassungen. Bleibt RAM übrig, laufen weitere Dienste wie Vaultwarden auf demselben Server. Grenzen: kurze Kontexte, ein Nutzer.
Ein Nutzer: Chat, n8n-Workflows, Coding-Assistent. VPS mit 16 GB RAM (VPS-Vergleich), Ollama, Gemma 4 12B oder Qwen3 14B. Einrichtung im Ollama-Guide.
Kleines Team, nicht alle gleichzeitig. Server mit 32 GB RAM (VPS oder Dedicated Server), llama.cpp-Server mit mehreren Slots oder Ollama mit höherem OLLAMA_NUM_PARALLEL, dazu Gemma 4 26B A4B oder Qwen3-30B-A3B. Gleichzeitige Anfragen teilen sich die Rechenleistung.
Viele gleichzeitige Nutzer. vLLM nennt Unterstützung für NVIDIA- und AMD-GPUs (laut vLLM-Doku, Stand: 08.11.2026); VRAM-Werte nennen die Modellkarten nicht. RackDiff listet derzeit keine GPU-Server.
Datenschutz als Motiv. Bei lokalem Betrieb sieht Ollama weder Prompts noch Daten; für Ollama-Cloud-Modelle gilt das nicht (laut Ollama-FAQ, Stand: 08.11.2026). Der Server-Anbieter bleibt beteiligt; was mit ihm zu vereinbaren ist, regelt Art. 28 DSGVO (laut DSGVO auf EUR-Lex, Stand: 08.11.2026). Mehr im Guide VPS in Deutschland & DSGVO.
Fazit
Erst das Modell wählen und MoE-Varianten prüfen, dann die gleichzeitige Last abschätzen und die Serving-Software danach einstellen, dann die RAM-Klasse wählen. Was Server dieser Klassen kosten, zeigen der VPS-Vergleich und der Dedicated-Vergleich mit Preisen inkl. USt.
Häufig gestellte Fragen
Läuft Gemma 4 31B auf einem CPU-VPS?
Wie viele gleichzeitige Nutzer schafft ein CPU-VPS?
Ollama oder vLLM?
Listet RackDiff GPU-Server?
Bleiben Prompts beim Self-Hosting auf meinem Server?
Weitere LLM- und Self-Hosting-Guides
Server für dein LLM finden
Vergleiche VPS und Dedicated Server; wie die Listen gewichtet sind, steht auf der Methodik-Seite.
Zum VPS-Vergleich